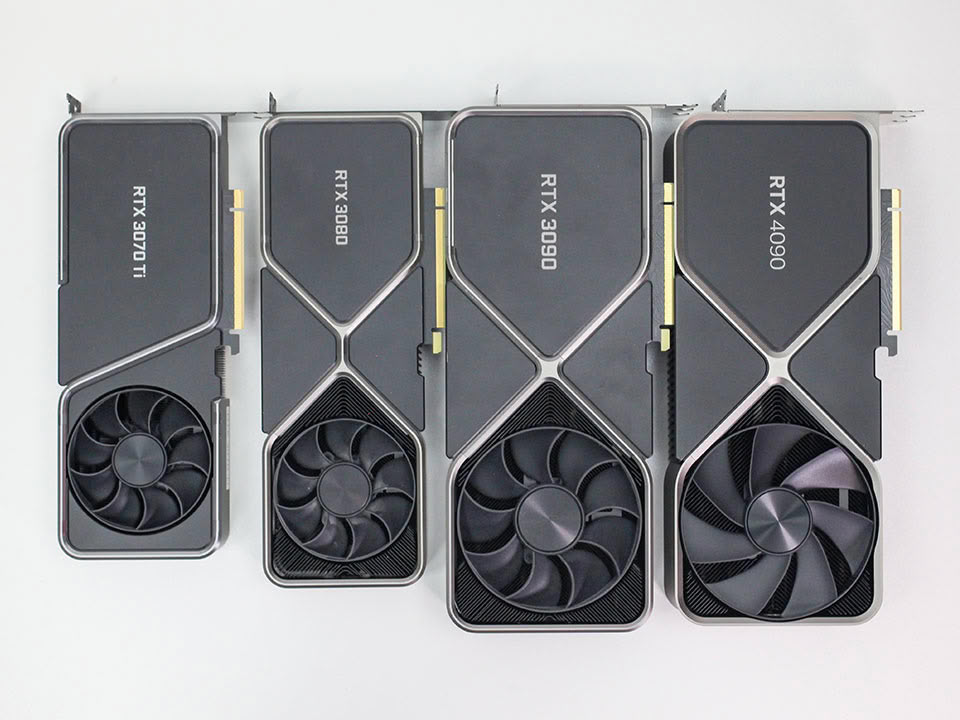
Plăcile grafice NVIDIA GeForce RTX din seriile RTX 30 și RTX 40 sunt bazate pe aceleași cipuri grafice (dies) ca modelele profesionale ale companiei. Acest lucru înseamnă că potențialul de calcul al plăcilor RTX destinate consumatorilor este limitat de stiva de firmware NVIDIA. Cu toate acestea, modderii au reușit să deblocheze o rată de emitere a instrucțiunilor echivalentă cu cea a modelelor profesionale corespunzătoare.
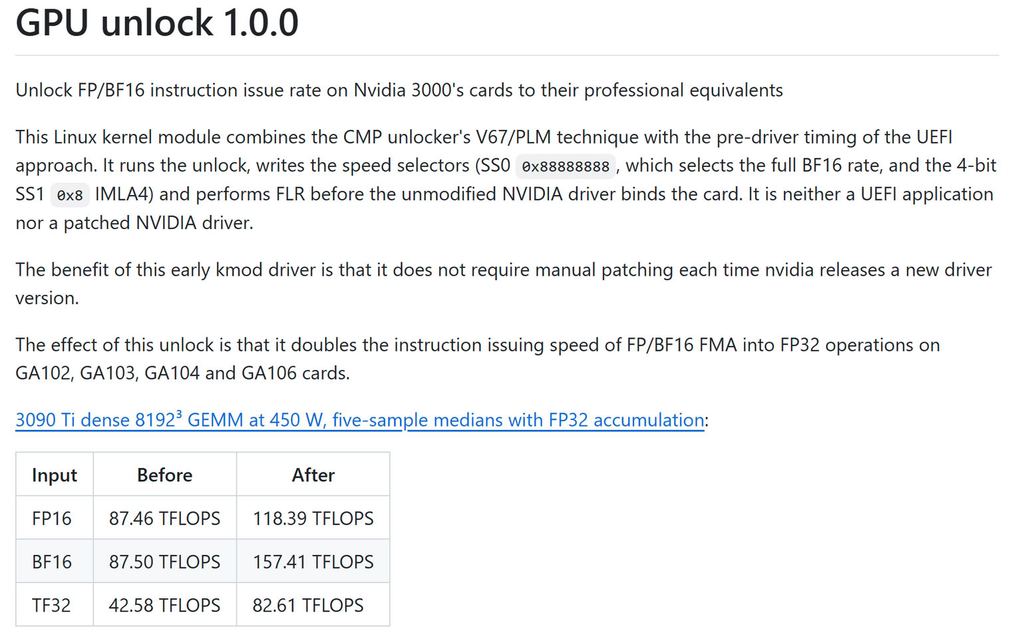
Începând cu seria GeForce RTX 30, cu arhitectura „Ampere”, un cercetător a dezvoltat o metodă de deblocare care practic dublează viteza de emitere a instrucțiunilor pentru operațiile FMA cu FP/BF16 în FP32 pe plăcile bazate pe cipurile GA102, GA103, GA104 și GA106.
Drept urmare, plăci grafice precum GeForce RTX 3090 Ti pot beneficia de o accelerare de până la 80% a operațiilor de înmulțire a matricelor în BF16, o funcție esențială pentru rularea aproape tuturor rețelelor neuronale. Metoda de deblocare este compatibilă cu plăcile grafice GeForce RTX bazate pe cipurile GA102, GA103, GA104 și GA106.
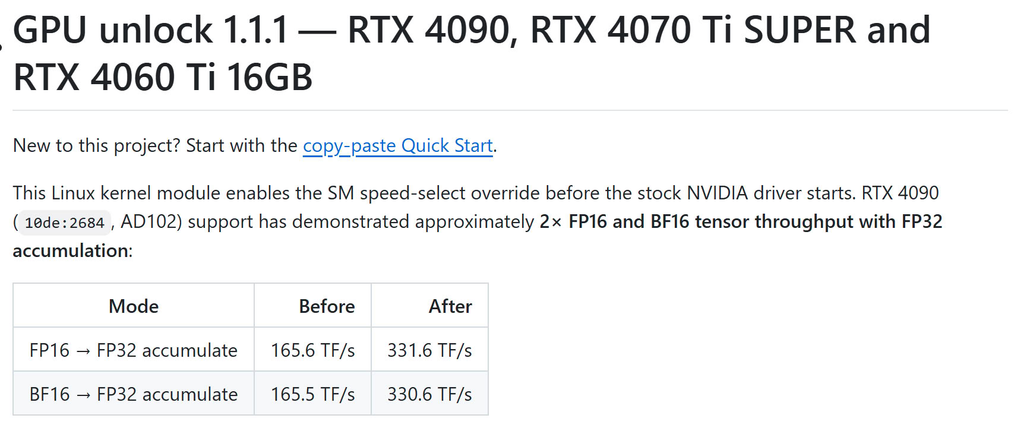
În continuare, avem seria GeForce RTX 40, bazată pe arhitectura „Ada Lovelace”, pentru care un alt proiect a demonstrat o accelerare masivă, de 2 ori, a debitului de calcul tensorial FP16 și BF16 cu acumulare FP32.
Atunci când GeForce RTX 4090 a fost testată pentru debitul de calcul tensorial FP16 și acumularea matricelor, placa grafică a atins 165,6 TFLOPS. După aplicarea deblocării, rezultatul a crescut la 331,6 TFLOPS.
Acest lucru este remarcabil, deoarece asemenea valori ale performanței de calcul sunt asociate, de regulă, segmentului profesional superior, reprezentat de modele precum NVIDIA RTX 6000 „Ada Lovelace”.
Se pare că NVIDIA a limitat artificial performanța cipului AD102 în operațiile de înmulțire și acumulare a matricelor sensibile la performanța de calcul, afectând inclusiv rularea modelelor lingvistice de mari dimensiuni (LLM). Pentru această metodă de deblocare, compatibilitatea este confirmată oficial pentru cipurile AD102, AD103 și AD106.
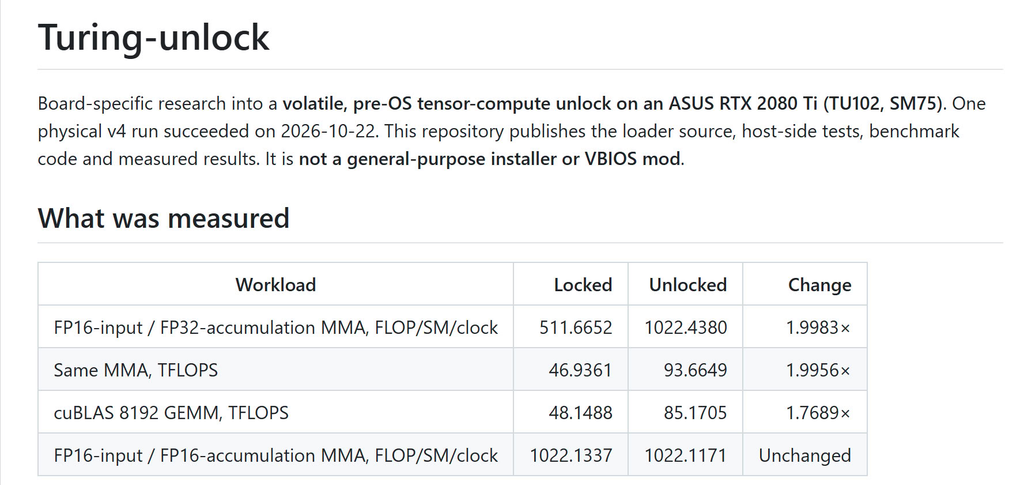
Cele două metode distincte de deblocare a plăcilor grafice au apărut aproape simultan: una a fost demonstrată pentru seria GeForce RTX 30, bazată pe arhitectura „Ampere”, iar cealaltă pentru seria GeForce RTX 40, bazată pe arhitectura „Ada Lovelace”.
Ambele metode trec cu succes de verificările driverelor NVIDIA și suprascriu mecanismul PCIe Function Level Reset (FLR), folosind în continuare driverele NVIDIA standard, iar testele de performanță CUDA se desfășoară în mod normal.
De exemplu, atât înainte, cât și după deblocare, consumul total al plăcii grafice (TGP) rămâne la 450 W pentru modelele bazate pe cipurile GA102 și AD102.
Pentru utilizatorii care rulează sarcini intensive de calcul, precum modelele lingvistice de mari dimensiuni (LLM) local, puterea de calcul suplimentară se traduce printr-un debit semnificativ mai mare de tokenuri atât în faza de preumplere (prefill), cât și în cea de generare (decode). Astfel, utilizatorii obișnuiți pot beneficia de performanțe superioare.
Totuși, este important de reținut că orice modificare adusă plăcii grafice anulează garanția. În plus, aceste modificări trebuie activate la pornirea sistemului, astfel încât să fie aplicate înainte ca driverele NVIDIA să asocieze placa grafică cu nucleul sistemului de operare (kernel).
About the Author